Table des matières :
- Pourquoi l’audit SEO technique se priorise désormais avec des signaux d’exploration (crawl) et Search Console ?
- Quels indicateurs tirer d’un crawl pour transformer une liste d’erreurs en plan d’action ?
- Comment exploiter Google Search Console pour qualifier l’impact et éviter les faux positifs ?
- Comment croiser crawl + Search Console pour construire une priorisation robuste ?
- Quelles corrections techniques ont généralement le meilleur ROI en 2026 ?
- Comment industrialiser l’audit : du ticket technique au suivi SEO, GEO, AEO et SGAEO ?
Pourquoi l’audit SEO technique se priorise désormais avec des signaux d’exploration (crawl) et Search Console ?
Un audit SEO technique produit souvent une liste d’alertes plus longue que le backlog d’une équipe web. La difficulté n’est pas de « trouver des problèmes », mais de décider quoi corriger en premier, avec un raisonnement traçable et partageable avec les équipes produit, développement et contenu. En 2026, cette priorisation peut s’appuyer sur deux sources complémentaires : un crawl (vue des URL accessibles au robot) et Google Search Console (données et rapports fournis par Google, qui ne couvrent pas nécessairement toutes les URL ni tous les états en temps réel).
Avant d’aller plus loin, clarifions les sigles qui reviennent dans les plans d’optimisation : SEO (Search Engine Optimization) vise la visibilité dans les résultats organiques classiques. AEO (Answer Engine Optimization) désigne les pratiques visant à faciliter la sélection d’un contenu comme réponse, par exemple dans un extrait optimisé ou une réponse directe. GEO (Generative Engine Optimization) désigne les pratiques visant à améliorer la visibilité ou la citabilité dans des moteurs génératifs et des assistants, comme les AI Overviews ou les chatbots. Enfin, SGAEO (Search Generative + Answer Engine Optimization) est ici employé comme un terme englobant ces pratiques ; ce n’est pas une catégorie normalisée. Ces objectifs se rejoignent sur un point : une base technique saine peut faciliter l’exploration, l’indexation et l’interprétation des contenus, sans garantir leur affichage ou leur citation.
Google rappelle dans sa documentation « Search Essentials » que des pages doivent être accessibles et indexables pour pouvoir apparaître dans les résultats (source : Google Search Central, « Search Essentials », consulté le 26/10/2026 : documentation Search Essentials de Google). Par ailleurs, les interfaces de recherche évoluent, notamment avec les AI Overviews. Une structure HTML compréhensible, des URL cohérentes et des données structurées valides peuvent faciliter l’interprétation des pages, mais ne garantissent ni leur sélection ni leur citation dans ces interfaces.
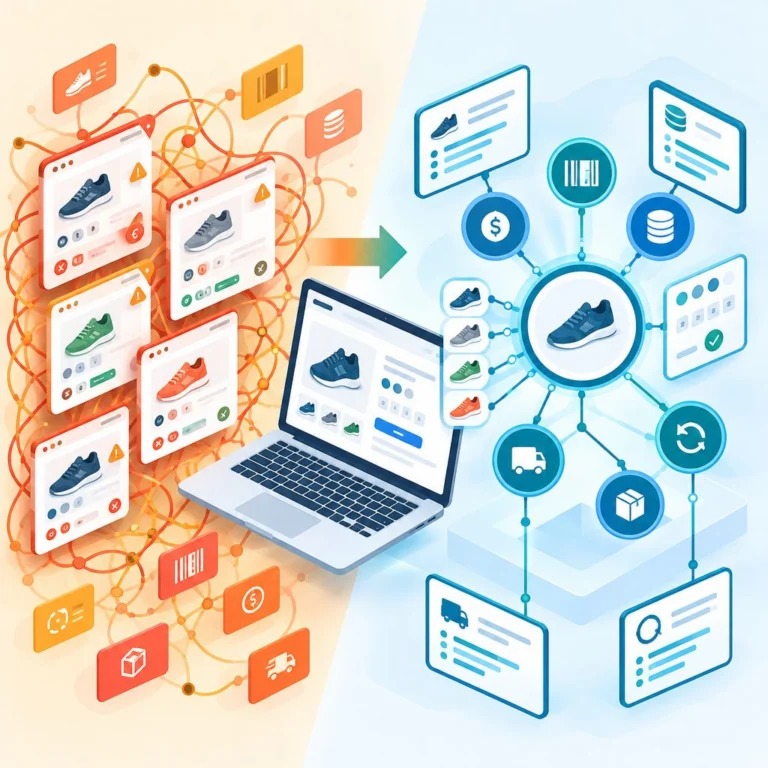
Un point souvent oublié dans la priorisation : le « technique » n’est pas qu’un sujet de performance. C’est aussi un sujet de réduction d’incertitude pour les moteurs. Exemple concret : deux URL proches (mêmes produits, tri différent, paramètres de suivi) peuvent produire des signaux contradictoires (contenu similaire, canoniques divergentes, liens internes mixtes). Google peut alors sélectionner une URL de référence différente de celle souhaitée, ce qui peut compliquer la consolidation des signaux et rendre les classements moins stables.
Enfin, pour ajouter une dimension de référencement international : si vous opérez dans plusieurs zones francophones (France, Belgique, Suisse, Canada), l’audit technique peut vérifier que Google comprend correctement le ciblage linguistique et régional (cohérence des URL et, si nécessaire, annotations hreflang). Des sitemaps distincts peuvent être utilisés selon l’architecture, mais ne sont pas obligatoires dans tous les cas. Ce point devient pertinent lorsqu’un site déploie des versions /fr, /fr-be, /fr-ch ou des sous-domaines.
Quels indicateurs tirer d’un crawl pour transformer une liste d’erreurs en plan d’action ?
Un crawl consiste à faire parcourir un site par un robot qui collecte des données sur les URL qu’il peut découvrir et accéder : codes HTTP, directives robots, balises canonical, titres, Hn, profondeur de clic, poids des pages, liens entrants et sortants, etc. C’est une façon de voir une partie du site comme un graphe, au lieu d’une somme d’URL isolées. Pour prioriser, l’objectif n’est pas d’atteindre « 0 erreur », mais d’identifier les problèmes qui bloquent ou dégradent fortement l’exploration et la consolidation des signaux.
Première famille d’indicateurs : l’accessibilité et la santé HTTP. Dans un audit, on classe systématiquement : 5xx (indisponibilités), 4xx (404, 410), 3xx (boucles, chaînes de redirections), 200 « parasites » (paramètres, facettes, pages de test). Les chaînes de redirection ajoutent des requêtes et peuvent compliquer l’exploration. Si une part importante des liens internes pointe vers des URL redirigées, le maillage peut être moins efficace et plus difficile à maintenir ; le seuil à partir duquel agir dépend du site et du contexte.
Pour rendre l’analyse actionnable, ajoutez dès le crawl 3 colonnes simples :
- Type de page / gabarit (catégorie, produit, article, page d’aide, moteur interne, facette, pagination, etc.)
- Rôle business (stratégique, support, légal, utilitaire)
- Source de découverte (liens internes, sitemap, URL isolée)
Cela transforme une liste d’URL en diagnostics « par modèle », ce qui permet souvent de repérer les problèmes de gabarit.
À titre de repère pragmatique, et non de norme universelle, voici des seuils qui peuvent déclencher une investigation :
| Signal au crawl | Pourquoi c’est prioritaire | Vérification rapide |
|---|---|---|
| 5xx sur des pages business | perte d’accès et risque de désindexation | journaux serveur / monitoring + recrawl ciblé |
| >5 % de liens internes vers des 3xx | maillage à vérifier et exploration potentiellement moins efficace | extraire les liens internes vers les redirections |
| canonicals vers des URL non-200 | consolidation potentiellement incohérente | lister les canonicals et vérifier le code HTTP |
| pages clés à plus de 4–5 clics | accessibilité potentiellement faible, surtout sur les gros sites | croiser profondeur et impressions GSC |
| forte hausse des paramètres explorables ou indexables | duplication et exploration potentiellement moins efficace | grouper par pattern d’URL |
Pour un rappel normatif sur les codes HTTP, utile quand il faut aligner SEO, développement et opérations, consultez la spécification HTTP (RFC 9110).
Deuxième famille : indexabilité et consolidation. Votre crawl doit permettre d’extraire et de croiser :
robotsmeta et X-Robots-Tag (noindex,nofollow)rel=canonical(auto-référentes, canonicals vers des URL 404, canonicals incohérentes)- pages quasi-dupliquées (titres identiques, contenu très proche)
- profondeur (pages importantes à plus de 4 à 5 clics)
Google précise que les canonicals sont une indication, pas une directive absolue, et qu’elles doivent être cohérentes avec le contenu (source : Google Search Central, « Consolidate duplicate URLs », consulté le 26/10/2026 : documentation sur la consolidation des URL dupliquées). Une canonicalisation cohérente peut contribuer à clarifier l’URL de référence et à consolider les signaux.
Exemple courant, surtout sur les sites e-commerce et éditoriaux avec des tags : des pages triées (?sort=price) reçoivent des liens internes, sont en 200 et indexables, mais ont une canonical différente selon le gabarit ou l’environnement (parfois en HTTP/HTTPS ou avec/sans barre oblique finale). Un crawl permet de détecter ce pattern, puis de standardiser : une URL canonique cohérente, un maillage qui pointe sur l’URL finale et une politique claire pour les variantes.
Troisième famille : maillage interne et pages orphelines. Un crawl peut mettre en évidence les pages présentes dans le sitemap mais qui ne sont pas liées depuis les pages découvertes, ainsi que celles qui sont liées mais absentes du sitemap. Il peut aussi aider à analyser la distribution des liens internes et la profondeur de crawl. Un audit technique peut aboutir à des actions éditoriales et structurelles : revoir l’arborescence, créer des pages piliers ou améliorer le maillage.
Deux mini-checklists utiles pour passer du constat à l’action :
- Checklist « orphelines » : (1) URL dans le sitemap ? (2) reçoit-elle des impressions GSC ? (3) est-elle stratégique ? (4) si oui, où la lier (navigation, page pilier, hub, catégorie) ? (5) sinon, faut-il la retirer du sitemap, la mettre en
noindexou la fusionner ? - Checklist « profondeur » : (1) pages qui convertissent ou doivent se positionner, (2) profondeur actuelle, (3) points d’entrée possibles (header, footer, blocs « à lire », fil d’Ariane, pages piliers), (4) vérifier après recrawl que la profondeur baisse réellement.
Pour relier technique et stratégie de contenu, vous pouvez vous appuyer sur votre approche « piliers et maillage interne » déjà détaillée dans cet article sur les pages piliers et le maillage interne.
Comment exploiter Google Search Console pour qualifier l’impact et éviter les faux positifs ?
Search Console fournit des rapports sur les URL que Google a explorées ou indexées, ainsi que sur les requêtes et impressions associées. Ces données sont utiles pour prioriser, mais elles ne couvrent pas nécessairement toutes les URL ni tous les états en temps réel. Un problème visible au crawl n’a pas forcément un impact réel si Google n’explore pas ces zones, si elles sont volontairement exclues ou si elles ne génèrent pas de demande.
Commencez par le rapport Indexation (Pages) : il répartit les URL indexées et non indexées selon différents états (exclues, découvertes mais non indexées, explorées mais non indexées, soft 404, pages avec redirection, bloquées par robots, etc.). Google précise que les libellés du rapport décrivent des états et ne désignent pas toujours des erreurs à corriger ; l’analyse doit se faire au cas par cas (source : Google Search Console Help, « Pages report », consulté le 26/10/2026 : documentation du rapport Pages). Une méthode utile consiste à trier ces états par volume, puis à échantillonner les URL pour comprendre les patterns (facettes, pagination, pages très fines, duplication, contenu faible, canonicals incohérentes).
Pour éviter les faux positifs, appliquez une logique simple : intention vs surprise.
- Intentionnel : pages de recherche interne, paniers, comptes, pages de filtre purement utilitaires, environnements de test correctement protégés — leur présence parmi les URL exclues peut être normale.
- Surprenant : pages catégories, pages produits principales ou guides qui reçoivent des backlinks ou sont censés attirer des visiteurs. Si elles apparaissent comme « explorées, mais non indexées », il faut en examiner la cause.
Ensuite, utilisez Inspection d’URL pour comparer l’état indiqué par Google, la canonical déclarée et la canonical sélectionnée par Google, la date du dernier crawl, ainsi que les ressources et le rendu lorsque ces informations sont disponibles. Google explique que des ressources nécessaires au rendu, telles que des fichiers CSS ou JavaScript, peuvent devoir être accessibles pour que Google comprenne correctement une page, notamment sur mobile.
Deux usages de l’Inspection d’URL pour prioriser :
- Comparer la canonical déclarée à celle sélectionnée par Google sur un échantillon : si Google sélectionne régulièrement une autre URL, cela peut signaler un manque de cohérence dans le maillage, le contenu, les paramètres ou les autres signaux.
- Vérifier la date du dernier crawl de pages stratégiques : si ces pages sont peu explorées, l’amélioration du maillage et la réduction des URL inutiles peuvent être à examiner avant des ajustements mineurs de balises.
Enfin, pour connecter technique et performance business, croisez les anomalies avec le rapport Performances (requêtes, pages, pays, appareils). Deux observations à garder en tête :
- Corriger un problème technique sur un ensemble de pages qui ne reçoit ni impressions ni clics n’est pas toujours prioritaire, sauf si ces pages sont stratégiques (produits, catégories, pages de destination).
- Une baisse de clics peut aussi venir d’un changement dans les résultats de recherche (AI Overviews, enrichissements), et pas uniquement d’un problème technique.
Pour ajouter une dimension de marché, le rapport Performances permet aussi de segmenter par pays. C’est particulièrement pertinent pour un site francophone : une anomalie technique (mauvaise canonicalisation, duplication, pages traduites proches) peut toucher différemment la France et la Belgique, par exemple, selon l’architecture des URL et les signaux de ciblage. Pour cadrer le suivi et adapter vos KPI face au « zéro clic », voir cet article sur l’adaptation des KPI SEO face au zéro clic.
Comment croiser crawl + Search Console pour construire une priorisation robuste ?
La priorisation devient plus claire quand vous superposez : (a) ce que votre crawler découvre, (b) ce que Google indique explorer et indexer et (c) ce que vos pages génèrent en visibilité ou en conversions. Une méthode simple consiste à créer une table par URL ou par gabarit avec ces colonnes : code HTTP, indexabilité (robots/noindex), canonical, profondeur, présence dans le sitemap, nombre de liens internes, état GSC (indexée, exclue, erreur), impressions/clics, type de page (blog, catégorie, produit, aide) et, si pertinent, revenu ou leads.
Deux recommandations pratiques pour que ce croisement reste exploitable :
- Travaillez par gabarit dès que possible (catégories, produits, articles…) : un bug de template peut concerner des milliers de pages.
- Ajoutez une colonne « pattern d’URL » (regex simple ou regroupement par répertoire / paramètres) : c’est souvent un moyen efficace de montrer qu’un problème est systémique.
Ensuite, appliquez une matrice Impact x Couverture x Risque :
- Impact : risque de perte de trafic, d’indexation ou de conversion si le problème n’est pas corrigé (ex. 5xx sur des pages business).
- Couverture : nombre d’URL concernées (ex. un bug de template affecte 30 000 pages).
- Risque : probabilité d’aggraver la situation en corrigeant (ex. refonte d’URL, règles de réécriture, canonicals globales).
Pour rendre la matrice opérationnelle en comité de priorisation, vous pouvez utiliser un scoring simple et transparent, par exemple sur une échelle de 1 à 5 :
| Critère | 1 | 3 | 5 |
|---|---|---|---|
| Impact | faible | moyen | élevé (pages stratégiques / indexation bloquée) |
| Couverture | <50 URL | 500–5 000 URL | >10 000 URL |
| Risque | faible (réglage isolé) | moyen | élevé (réécriture, migration, règles globales) |
Vous pouvez ensuite prioriser par : (Impact x Couverture) / Risque, puis ajuster selon le contexte (capacité de développement, calendrier marketing, contraintes légales).
Google recommande de faciliter l’exploration, de fournir un sitemap fiable et d’éviter de bloquer des contenus importants via robots ou noindex sans intention claire (sources : Google Search Central, « Sitemaps overview » et « Robots.txt », consultées le 26/10/2026 : documentation sur les sitemaps et documentation sur robots.txt). Dans la pratique, des problèmes systémiques (gabarit, règles d’URL, pagination, facettes) peuvent être plus efficaces à traiter que des micro-optimisations page par page. Réduire les URL inutiles, les redirections internes et les duplications peut aussi améliorer la part d’exploration consacrée aux pages utiles.
Exemple hypothétique de site e-commerce avec 80 000 URL explorables :
- Crawl : 18 % des liens internes pointent vers des URL en 302, et plus de 6 000 URL de filtres sont indexables.
- GSC : forte proportion d’URL de filtres « découvertes, mais non indexées », et des catégories stratégiques « explorées, mais non indexées ».
- Action priorisée : corriger le maillage pour pointer directement vers des URL en 200, définir des règles cohérentes pour les facettes et fiabiliser le sitemap.
- Résultats à mesurer après le déploiement, sur plusieurs semaines : évolution du nombre d’URL exclues, cohérence des canonicals sélectionnées par Google et impressions sur les catégories principales. Ces évolutions varient notamment selon la fréquence d’exploration et ne sont pas garanties.
Dans ce type de cas, une méthode de priorisation consiste à commencer par les catégories ou les hubs avant les fiches produits, car elles peuvent servir de pages de destination SEO et de nœuds de maillage interne. Une catégorie stabilisée (URL canonique claire, pagination cohérente, facettes maîtrisées) peut ensuite faciliter la découverte des produits.
Quelles corrections techniques ont généralement le meilleur ROI en 2026 ?
Les corrections qui peuvent présenter le meilleur ROI sont celles qui améliorent (1) l’exploration, (2) l’indexation, (3) la compréhension et (4) l’expérience. Première priorité : résoudre les erreurs bloquantes (5xx, pages stratégiques en 404, robots qui bloquent des répertoires utiles, migrations incomplètes). Chaque correction doit être testée sur un environnement de préproduction, avec un échantillon d’URL et un plan de rollback. Les corrections qui rétablissent l’accès à des pages importantes peuvent justifier une intervention rapide.
Deuxième priorité : stabiliser les signaux d’URL (canonicals, paramètres, pagination). Les sites modernes génèrent facilement des variantes : tri, filtres, suivi, variantes de produits, pages d’impression, versions AMP résiduelles. Côté technique, l’objectif est de choisir quelles variantes doivent être indexables, puis de rendre ce choix cohérent entre les liens internes, le sitemap, les canonicals, les directives robots et, éventuellement, la gestion des paramètres. Google indique que rel=canonical sert à consolider des URL dupliquées ou très proches, mais que Google peut sélectionner une autre canonical si les signaux divergent (source : documentation de Google sur les URL dupliquées, consultée le 26/10/2026). En pratique, les incohérences peuvent être détectées en croisant un crawl et l’Inspection d’URL.
Actions qui peuvent être utiles, surtout sur les sites à forte volumétrie :
- Nettoyer le maillage interne pour pointer directement vers l’URL finale en 200, afin de réduire les redirections internes.
- Fiabiliser le sitemap : y inclure des URL canoniques, en 200, indexables et utiles.
- Encadrer les paramètres : éviter que des variations sans valeur deviennent explorables et indexables.
- Homogénéiser la pagination, notamment lorsque des pages paginées génèrent des duplications de titres ou de H1, ou donnent accès à des pages vides.
Troisième priorité : performance et rendu. Depuis le remplacement de FID par INP dans les Core Web Vitals, l’attention porte davantage sur la réactivité globale et les interactions. Google indique que les Core Web Vitals évaluent des aspects de l’expérience utilisateur et que les données de terrain proviennent de mesures réelles lorsqu’elles sont disponibles (source : Google Search Central, « Core Web Vitals », consulté le 26/10/2026 : documentation sur les Core Web Vitals). Les actions à examiner peuvent inclure la réduction du JavaScript bloquant, l’optimisation des images (formats adaptés, dimensions explicites), le contrôle des tags marketing et une mise en cache efficace.
Une nuance utile pour la priorisation : si vos pages sont lentes en laboratoire, mais que les données de terrain sont correctes et que l’exploration et l’indexation sont saines, l’urgence peut être moindre que celle d’un problème d’indexation. À l’inverse, si un rendu JavaScript empêche Google de voir un contenu clé ou des liens internes, le rendu devient aussi un sujet de découverte.
Enfin, une partie technique peut contribuer à l’AEO, au GEO et au SGAEO : la structuration sémantique et les données structurées. Les données structurées n’assurent pas l’affichage d’un résultat enrichi et ne garantissent pas la sélection d’un contenu par un moteur génératif. Pour les pages FAQ, la logique est détaillée dans cet article sur l’optimisation des FAQ. Pour rendre vos contenus plus faciles à parcourir et à citer (passages clairement délimités, définitions, étapes), vous pouvez aligner la technique (HTML, ancres, tableaux) avec l’éditorial : conseils sur les passages citables par les IA.
Comment industrialiser l’audit : du ticket technique au suivi SEO, GEO, AEO et SGAEO ?
Un audit technique utile se termine par un système de pilotage, pas par un PDF. Concrètement, chaque recommandation doit devenir un ticket avec : (a) les pages impactées, (b) le symptôme constaté dans le crawl et/ou GSC, (c) l’hypothèse de cause (template, règle serveur, JS, CMS), (d) la solution proposée, (e) le niveau de risque, (f) la méthode de validation (recrawl, GSC, monitoring) et (g) la métrique attendue (ex. baisse des 5xx, évolution du nombre de pages indexées, diminution des redirections internes).
Pour faciliter l’exécution et éviter les tickets trop vagues, ajoutez systématiquement :
- Exemples d’URL (3 à 10) et pattern (ex.
/categorie?couleur=) - Avant/Après attendu (ex. « liens internes → URL en 200 », « canonical auto-référente »)
- Critère d’acceptation (ex. « aucun lien interne vers une 302 sur ce gabarit », « le sitemap ne contient plus d’URL paramétrées »)
Pour la mesure, distinguez bien les trois niveaux :
- Officiel : GSC fournit les statuts d’indexation et les données de performance de Google disponibles dans ses rapports. Les rapports et définitions sont documentés dans Search Console Help.
- Observé : un recrawl après déploiement permet de vérifier l’évolution du pattern (ex. liens internes en 302, canonicals corrigées, sitemap mis à jour). Vous pouvez aussi suivre les journaux serveur (log analysis) si vous en disposez, mais ce n’est pas obligatoire pour commencer.
- Hypothèse : l’amélioration de la citabilité dans les LLM et les réponses génératives ne se mesure pas uniquement via GSC. Elle nécessite des dispositifs complémentaires (requêtes de test, suivi de mentions, analyse de citations). Sur ce volet, une méthodologie dédiée à la mesure de la visibilité dans les LLM est détaillée, avec également un cadre d’optimisation GEO de la citabilité.
Industrialiser, c’est aussi documenter les garde-fous : checklists de mise en ligne (HTTP, indexabilité, canonicals), tests automatiques (headers, robots, sitemaps) et règles éditoriales (quand créer une nouvelle URL plutôt qu’enrichir une URL existante). Avec cette discipline, l’audit devient un cycle continu : on corrige, on valide par un recrawl, on vérifie l’évolution dans GSC, puis on réajuste le maillage et le contenu. Cette boucle est particulièrement importante quand les résultats de recherche évoluent (AI Overviews, enrichissements), car elle aide à distinguer un changement d’interface d’un problème technique.
Une cadence réaliste, qui évite le « one shot » :
- Chaque semaine : suivi des erreurs critiques (5xx, pages stratégiques en 404, anomalies robots) et échantillonnage des nouveaux patterns.
- Chaque mois : recrawl complet ou par répertoire, revue des exclusions GSC par volume et mise à jour de la matrice de priorisation.
- Chaque trimestre : revue structurelle (arborescence, hubs, pagination/facettes) et alignement SEO–Produit sur les nouvelles fonctionnalités et les nouveaux templates.
Action prioritaire à réaliser sur votre site : exportez depuis Search Console la liste des URL « explorées, mais non indexées » et « découvertes, mais non indexées », puis recrawlez un échantillon de ces URL pour identifier le pattern dominant (duplication, facettes, pages faibles, canonicals incohérentes) et corrigez d’abord la cause systémique au niveau du template ou des règles d’URL.