Pourquoi les données structurées SEO comptent encore en 2026 (et à quoi elles ne servent pas)
Les données structurées SEO consistent à ajouter, dans le code d’une page, des informations normalisées décrivant son contenu sous forme d’« entités » (produit, entreprise, article, recette, événement). L’objectif n’est pas de « tromper » l’algorithme, mais de réduire l’ambiguïté sur ce que vous présentez.
Sur ce point, Google explique (en anglais, dans sa documentation Search Central) que les structured data sont « a standardized format for providing information about a page and classifying the page content » (Google Search Central, page “Intro to structured data”, consultée le 2026-11-09). Autrement dit : vous aidez le moteur à classer et interpréter ce qu’il voit déjà, au lieu de lui laisser deviner.
Il faut distinguer trois niveaux, sinon on sur-interprète vite le rôle de Schema.org.
1) Ce qui est documenté officiellement : les moteurs utilisent les données structurées pour rendre une page éligible à certaines fonctionnalités d’affichage (rich results) et pour mieux interpréter le contenu. Point important : un balisage valide peut rendre une page éligible, mais ne garantit pas l’affichage d’un résultat enrichi. D’autres critères peuvent aussi compter, comme le respect des consignes, la pertinence et le contexte de la requête.
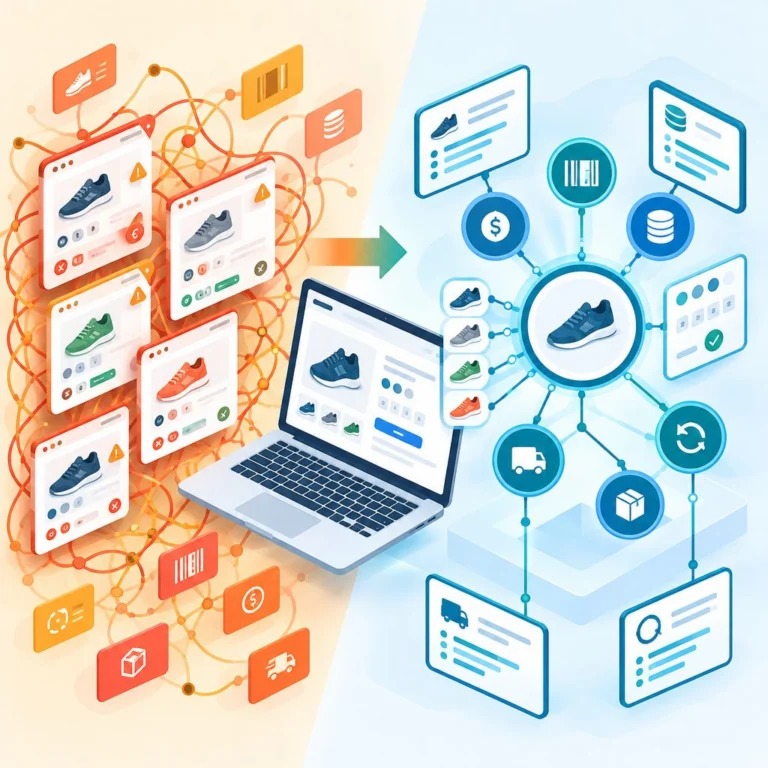
2) Ce qui est observé sur le terrain (sur des périmètres variables) : quand les rich results sont déclenchés, on constate souvent une amélioration du CTR sur des requêtes comparables, parce que l’extrait devient plus “décidable” (prix, stock, avis, fil d’Ariane). En e-commerce, le balisage Product/Offer correctement alimenté tend aussi à réduire les incompréhensions entre ce qui est affiché et ce qui est réellement vendu (prix incohérent, devise incorrecte, page indisponible malgré un stock annoncé, etc.) — et à faciliter le diagnostic des écarts dans Search Console.
3) Ce qui relève de l’hypothèse : dans un contexte de recherche assistée par IA, il est tentant d’affirmer que « Schema = citation ». En pratique, la relation est plus indirecte. Les données structurées peuvent faciliter l’extraction d’attributs fiables (marque, référence, auteur, date), mais la citation dans les moteurs génératifs peut aussi dépendre de facteurs comme la notoriété de la source, la redondance inter-sites, la fraîcheur et la capacité de votre contenu à fournir des passages citables.
Pour éviter les confusions, voici un repère utile (et pragmatique) :
- SEO (Search Engine Optimization) : visibilité dans les résultats “classiques” (liens bleus et enrichissements quand ils sont disponibles).
- AEO (Answer Engine Optimization) : capacité à fournir des réponses directes (extraits optimisés, assistants).
- GEO (Generative Engine Optimization) : capacité à être repris/cité dans des réponses génératives (AI Overviews, ChatGPT, Perplexity, Gemini).
- SGAEO : terme de travail, non normalisé, désignant la convergence “Search Generative + Answer Engine Optimization”, où l’on optimise à la fois l’éligibilité machine (données, structure) et la qualité éditoriale (preuves, définitions, exemples), sans promesse de positionnement.
À garder en tête : les données structurées aident surtout à (a) réduire l’ambiguïté, (b) industrialiser la cohérence à l’échelle d’un site, (c) éviter des pertes (mauvaise interprétation d’un prix, d’une disponibilité, d’un auteur). Ce n’est pas un bouton “+10 positions”.
Schema.org et JSON-LD : de quoi parle-t-on exactement ?
Schema.org est l’un des vocabulaires les plus utilisés pour décrire des entités sur le web. Sa vocation est explicitement collaborative : « Schema.org is a collaborative, community activity with a mission to create, maintain, and promote schemas for structured data on the Internet… » (Schema.org, “About”, consulté le 2026-11-09). Concrètement, Schema.org fournit des types (Product, Article, Organization) et des propriétés (name, brand, author, offers) que les moteurs peuvent comprendre.
Le format recommandé aujourd’hui pour le SEO est très souvent le JSON-LD (JavaScript Object Notation for Linked Data). C’est un bloc JSON inséré dans la page, généralement dans le <head> (ou parfois en bas du <body>), qui décrit un graphe d’entités. Sur le plan standard, JSON-LD s’inscrit dans l’écosystème du Web sémantique (JSON-LD 1.1 est une Recommendation du W3C, publiée en 2020), ce qui explique sa popularité au-delà du SEO.
Les champs clés sont :
@context: le contexte, souventhttps://schema.org.@type: le type d’entité (ex.Product).@id: un identifiant stable (URL ou URI) permettant de relier la même entité à travers plusieurs pages.
L’intérêt du JSON-LD est double :
1) il évite de “polluer” le HTML avec des attributs (contrairement au microdata), ce qui facilite la maintenance côté front/design system ;
2) il permet de modéliser plusieurs entités liées (par exemple : une page produit qui référence l’Organization du site, la Brand du produit et une Offer).
Sur le plan technique, pensez “graphe” plutôt que “snippet”. Si vous utilisez @graph, vous pouvez déclarer plusieurs nœuds : une Organization (votre entreprise), un WebSite, une WebPage et l’entité principale (mainEntity) de la page. En SEO, la cohérence des identifiants (@id), la correspondance avec les URL canoniques et la stabilité des propriétés clés (nom de marque, adresse, logo) permettent de limiter les incohérences dans le temps.
Mini-scénario (fréquent en refonte) : vous changez la structure d’URL d’un catalogue (ex. /produits/ → /boutique/). Si vos @id et offers.url pointent encore vers l’ancienne structure, Search Console peut remonter des incohérences, et Google peut associer l’entité produit à une URL non canonique. Résultat : vous “payez” la dette technique au moment où vous avez besoin de stabilité.
Quelles données structurées implémenter en priorité selon vos pages ?
Le point de départ doit être l’intention de la page et les types de rich results réellement supportés par Google. Officiellement, Google publie une liste de types de données structurées éligibles à des fonctionnalités d’affichage, avec des propriétés requises ou recommandées (Google Search Central, “Structured data feature guide”, consulté le 2026-11-09). Tout ce qui est “valide Schema.org” n’est donc pas forcément “utile pour Google”.
Une manière simple de prioriser (sans sur-balisage) consiste à raisonner en 3 questions :
- Quelle est l’entité principale de la page (produit, établissement, article) ?
- Quel enrichissement d’affichage est réaliste et pertinent sur ce type de page ?
- Quelles propriétés sont critiques pour éviter une mauvaise interprétation (prix, stock, auteur, adresse, date) ?
Pour un site e-commerce, la priorité va souvent à :
- Product + Offer : prix, devise, disponibilité, état, marque, GTIN, SKU. Cela sert à aligner ce que voit l’utilisateur dans l’extrait avec ce qui est sur la page.
- Astuce opérationnelle : si vous avez des prix dynamiques (promotions, prix selon les variations), définissez une règle “source de vérité” (DOM visible ou données back-office) et assurez-vous que le JSON-LD suit exactement la même source.
- AggregateRating et Review : uniquement si vos avis respectent les règles (avis visibles, authentiques, non trompeurs, contexte autorisé). Les guidelines Google sont strictes et évoluent : mieux vaut ne pas baliser que baliser de façon discutable.
- BreadcrumbList : utile pour clarifier la hiérarchie (catégorie, sous-catégorie, produit) et contribuer à l’affichage du fil d’Ariane.
Pour un site éditorial ou un blog, les types les plus robustes sont :
- Article ou BlogPosting : auteur, date de publication, date de mise à jour, image principale. C’est particulièrement pertinent si vous travaillez l’EEAT et la traçabilité des contenus (voir aussi votre article interne sur la rédaction SEO, EEAT et passages citables par les IA).
- Bon réflexe : soignez la cohérence entre
dateModified(JSON-LD) et la date “mise à jour” affichée à l’écran. Les décalages répétés (mise à jour dans le schema mais pas sur la page) finissent par créer de la méfiance… humaine et algorithmique. - Organization (au niveau site) et Person (pour les auteurs) : cohérence des profils et des sources (mêmes noms, mêmes URLs, mêmes liens
sameAsofficiels). - FAQPage : à utiliser quand la page contient une vraie FAQ visible, structurée et utile. La présence de ce balisage ne garantit pas l’affichage d’un résultat enrichi : Google réserve généralement les résultats enrichis de type FAQ aux sites gouvernementaux et de santé faisant autorité. Vous avez un guide dédié : FAQPage : optimiser vos FAQ pour AI Overviews et featured snippets.
Pour des entreprises locales ou multi-sites, LocalBusiness (ou un sous-type adapté) est souvent un socle : adresse, horaires, zone desservie, sameAs vers des profils officiels. Même si le balisage ne “crée” pas de visibilité locale à lui seul, il contribue à la cohérence des informations, surtout quand plusieurs sources (site, annuaires, fiches établissement) doivent converger.
Point “geo” utile (sans surcharger) : si vous avez 10 agences en France, évitez un LocalBusiness unique global. Préférez :
- 1 page = 1 établissement avec une adresse complète (
streetAddress,postalCode,addressLocality,addressCountry: "FR"), - un
@idstable par établissement, - des horaires alignés avec ce qui est affiché sur la page (jours fériés : si vous ne pouvez pas les gérer proprement, mieux vaut rester simple).
Table de priorisation (pratique pour cadrer un backlog) :
| Type de page | Schéma(s) prioritaires | Propriétés “à verrouiller” | Erreurs typiques |
|---|---|---|---|
| Fiche produit | Product + Offer |
name, image, sku/gtin, offers.price, priceCurrency, availability, offers.url |
prix/devise ≠ page, URL non canonique, stock faux |
| Article de fond | Article/BlogPosting |
headline, image, author, datePublished, dateModified, mainEntityOfPage |
auteur absent, dates incohérentes, image non représentative |
| Page établissement | LocalBusiness |
name, address, openingHours, telephone, sameAs |
adresse tronquée, horaires non visibles, entités dupliquées |
| FAQ intégrée | FAQPage |
questions/réponses visibles et identiques | FAQ balisée mais non affichée, réponses promotionnelles |
Bonnes pratiques JSON-LD : ce que Google attend, ce que l’on constate, ce qu’il vaut mieux éviter
Officiellement, la règle la plus importante est la correspondance entre le balisage et le contenu visible. Les moteurs peuvent considérer comme abusif un balisage qui annonce un prix, une disponibilité, un auteur ou des FAQ qui ne sont pas réellement présentés à l’utilisateur. Dans les projets réels, la majorité des problèmes vient moins de Schema.org que de l’industrialisation : modèles de pages, plugins multiples, variations de devises, traductions, contenus conditionnels.
Sur le terrain, trois bonnes pratiques font une différence nette en maintenance :
- Stabiliser les
@id: utilisez un identifiant durable par entité (par exemple l’URL canonique du produit, ou une URI interne). Cela évite de “recréer” l’entité à chaque changement de paramètre d’URL. - Exemple : pour un produit décliné par taille/couleur, ne changez pas de
@idau gré d’un paramètre?variant=si l’entité principale reste “le même produit” ; sinon vous fragmentez le graphe. - Éviter les doublons : un même type injecté par deux modules différents produit des incohérences. C’est particulièrement fréquent sur Shopify ou les CMS à plugins. Pour un cas e-commerce, voir votre article interne : Données structurées Shopify : compléter le schéma Product sans doublon.
- Modéliser l’essentiel, pas tout : Schema.org est vaste, mais un balisage “exhaustif” est souvent contre-productif si les champs sont partiellement faux, obsolètes ou contradictoires. Mieux vaut 12 propriétés fiables que 60 champs approximatifs.
Voici un exemple réaliste (simplifié) de Product en JSON-LD. Il illustre les points clés : @id, marque, offre et alignement sur une URL canonique.
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "Product",
  "@id": "https://www.exemple.com/produits/chaussure-trail-x#product",
  "name": "Chaussure de trail X",
  "image": [
    "https://www.exemple.com/media/chaussure-trail-x-1.jpg"
  ],
  "description": "Chaussure de trail légère avec semelle accrocheuse.",
  "sku": "TRAILX-42",
  "brand": {"@type": "Brand", "name": "MarqueY"},
  "gtin13": "1234567890125",
  "offers": {
    "@type": "Offer",
    "url": "https://www.exemple.com/produits/chaussure-trail-x",
    "priceCurrency": "EUR",
    "price": "129.90",
    "availability": "https://schema.org/InStock",
    "itemCondition": "https://schema.org/NewCondition"
  }
}
</script>
Deux raffinements souvent utiles (sans complexifier à l’excès) :
- Relier l’offre à la bonne “version” de la page : si vous avez une canonique propre, alignez
offers.urlsur la canonique (pas sur une URL de tracking, pas sur une URL avec paramètres). - Rendre explicite l’entité “site” : quand vous avez de nombreux auteurs, marques ou établissements, le fait de relier une
Organizationunique via des@idcohérents évite les variations (logo différent selon page, nom juridique fluctuant, etc.). C’est plus un sujet de gouvernance éditoriale que de “technique pure”.
Côté erreurs fréquentes, retenez une checklist simple :
(1) prix/devise incohérents entre page et JSON-LD,
(2) URLs non canoniques dans offers.url,
(3) avis balisés mais non visibles,
(4) propriétés requises manquantes pour les rich results ciblés,
(5) balisage déployé sur des pages non indexables (noindex, canonicals incorrectes, pages filtrées).
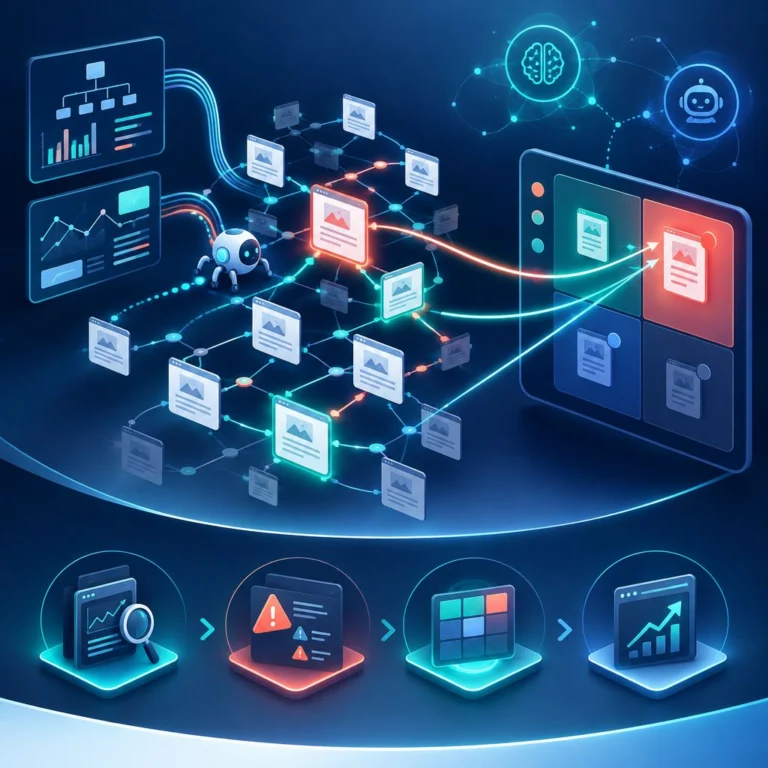
Ces points se diagnostiquent bien dans un audit SEO technique avec crawl et Search Console.
Comment valider, déployer et suivre vos données structurées sans créer de dette technique ?
Officiellement, Google fournit des outils et rapports dédiés : le Rich Results Test (validation orientée fonctionnalités Google) et les rapports de résultats enrichis disponibles dans Google Search Console (suivi des erreurs et avertissements pour les types pris en charge). En complément, le Schema Markup Validator (Schema.org) aide à valider la conformité au vocabulaire, même lorsque Google ne propose pas de résultat enrichi associé.
Pour valider rapidement une URL en condition réelle, l’outil le plus simple à mettre dans vos routines QA est le test de résultats enrichis : Rich Results Test (Google).
L’enjeu n’est pas seulement de “passer en vert”, mais de maintenir des données cohérentes lors des évolutions de catalogue, de design system ou de CMS. Dans la pratique, la “dette technique schema” apparaît quand :
- plusieurs équipes injectent du JSON-LD sans gouvernance (thème + app + tag manager),
- des champs deviennent faux au fil du temps (horaires, prix, auteur),
- on déploie des schémas sur des pages que l’on finit par canonicaliser ou mettre en noindex (le balisage “survit”, mais ne sert plus).
Sur le terrain, les équipes qui évitent les régressions mettent en place une approche proche du QA applicatif :
- Tests sur gabarits : valider 5 à 10 URL représentatives par template (fiche produit, catégorie, article, FAQ, page marque).
Astuce : conservez une liste “golden URLs” (toujours indexables, stables) pour comparer avant/après une release. - Contrôles en CI/CD : lors d’une mise en production, vérifier automatiquement la présence des blocs JSON-LD attendus et l’absence de doublons.
- Journalisation et monitoring : corréler les erreurs Search Console avec des changements de thème, d’app ou de module (ex. : “erreurs Offer apparues le lendemain d’une refonte du composant prix”).
Pour mesurer l’impact business, évitez l’attribution simpliste “j’ai ajouté du schema donc j’ai gagné X positions”. Une méthode plus robuste consiste à suivre :
1) l’évolution des impressions et du CTR sur les pages éligibles,
2) la part de trafic sur les requêtes à intention transactionnelle (souvent “produit + prix”, “référence + stock”),
3) la stabilité des extraits (moins de variations de prix ou de fil d’Ariane),
4) et surtout l’alignement avec les conversions (taux d’ajout au panier, leads, appels, demandes d’itinéraire pour le local).
Et, dans un monde où le zéro clic progresse, reliez ce suivi à vos KPI de conversion, comme expliqué dans AI Overviews : adapter KPI SEO et suivi conversions face au zéro clic.
Données structurées, AI Overviews et LLM : que peut-on raisonnablement en attendre ?
Ce que les plateformes documentent officiellement, aujourd’hui, reste centré sur la recherche classique : les données structurées servent à l’éligibilité aux fonctionnalités et à la compréhension du contenu. Il n’existe pas (à la date du 2026-11-09) de déclaration publique permettant d’affirmer qu’un balisage Schema.org entraîne mécaniquement une citation dans une réponse générative. Pour la plupart des organisations, l’objectif réaliste est donc de renforcer la machine-readability de vos pages, sans confondre cela avec un “ticket d’entrée” automatique dans les réponses IA.
Ce qui est observé (avec prudence, car les périmètres d’étude varient selon les verticales) : les pages qui combinent :
- (1) une entité clairement définie,
- (2) des attributs non ambigus (auteur, date, références produit),
- (3) une structure éditoriale nette (définitions, listes, tableaux),
…sont plus simples à résumer, à comparer et à réutiliser dans des synthèses. Dit autrement : Schema aide à nommer et lier les choses ; la rédaction aide à prouver et expliquer les choses.
Cela rejoint une logique GEO : améliorer la citabilité via structure, données et fraîcheur, comme détaillé dans GEO : optimiser la citabilité LLM via structure, données et fraîcheur et mesuré via un audit GEO 2026.
Ce qui reste hypothétique, mais actionnable sans risque : considérer les données structurées comme une couche d’alignement entre (a) votre contenu humain, (b) vos entités et attributs, (c) vos liens internes.
Exemple concret (local + éditorial) : un cabinet multi-sites publie un article “Prix d’un détartrage” et des pages établissement “Cabinet Paris 11”, “Cabinet Lyon 6”.
- Côté contenu : l’article cite des définitions, des cas, des fourchettes, et renvoie vers les pages locales pertinentes.
- Côté structure : l’article est balisé
Article(auteur + dates), chaque établissement est baliséLocalBusiness(adresse + horaires), et le maillage interne +BreadcrumbListclarifient la hiérarchie.
Même sans promesse de résultats enrichis, vous réduisez l’ambiguïté sur qui publie quoi et où, ce qui aide à la réutilisation fiable.
Enfin, une stratégie de pages piliers et de maillage interne (voir SEO 2026 : pages piliers et maillage interne pour visibilité durable) peut être renforcée par des BreadcrumbList, des @id stables et des relations explicites (marque, catégorie, auteurs). Dans une approche SGAEO, on vise un ensemble cohérent : balisage propre, pages bien structurées et passages informatifs facilement extractibles.
Action prioritaire à réaliser sur votre site : auditez 10 URL représentatives (un gabarit par type de page) avec Rich Results Test et Search Console, puis corrigez en priorité les doublons JSON-LD et les incohérences entre contenu visible et propriétés offers.price, availability, dateModified et author.